Comprendre le fonctionnement des IA générative permet d’éviter de se retrouver piégé dans les discours approximatifs et souvent érronés à propos de ce que font ou pas les modèles, sur la façon dont ils ont été entrainés et dont ils fonctionnent.
Voici les notions clés pour la création de texte (LLM) et pour la création d’images (diffusion).
Comment fonctionne un LLM ? Une explication en 12 étapes
Les grands modèles de langage (LLM) comme ChatGPT ou Claude semblent comprendre et rédiger du texte. Pourtant, ils ne font qu’une seule chose : prédire le mot suivant.
Cette animation de 2 minutes 30 suit une phrase simple, « Le chat boit du… », et montre comment un LLM la complète. Elle se déroule en deux parties.
A · L’entraînement. Le modèle apprend la langue à partir de milliers de milliards de mots. Il devine le mot suivant, se trompe, et ses paramètres sont corrigés, des milliards de fois. Des humains l’aident ensuite à formuler des réponses utiles (fine-tuning et RLHF).
B · La génération. Le texte est découpé en tokens, puis transformé en vecteurs qui encodent le sens et la position de chaque mot. Grâce au mécanisme d’attention, chaque mot tient compte des précédents. Le modèle attribue ensuite une probabilité à chaque suite possible, en choisit une, et recommence jusqu’à la fin de la réponse.
Une dernière scène montre le rôle du contexte. Seule, la phrase « Le chat boit… » appelle « du lait ». Mais si l’on précise qu’on vient de remplir un bol d’eau au robinet pour le chat, le modèle répond « de l’eau ».
Comment l’IA crée-t-elle des images ?
Les générateurs d’images comme Midjourney, DALL·E ou Stable Diffusion reposent sur une méthode appelée diffusion. Le principe est simple : on apprend à un réseau de neurones à retirer du bruit d’une image.
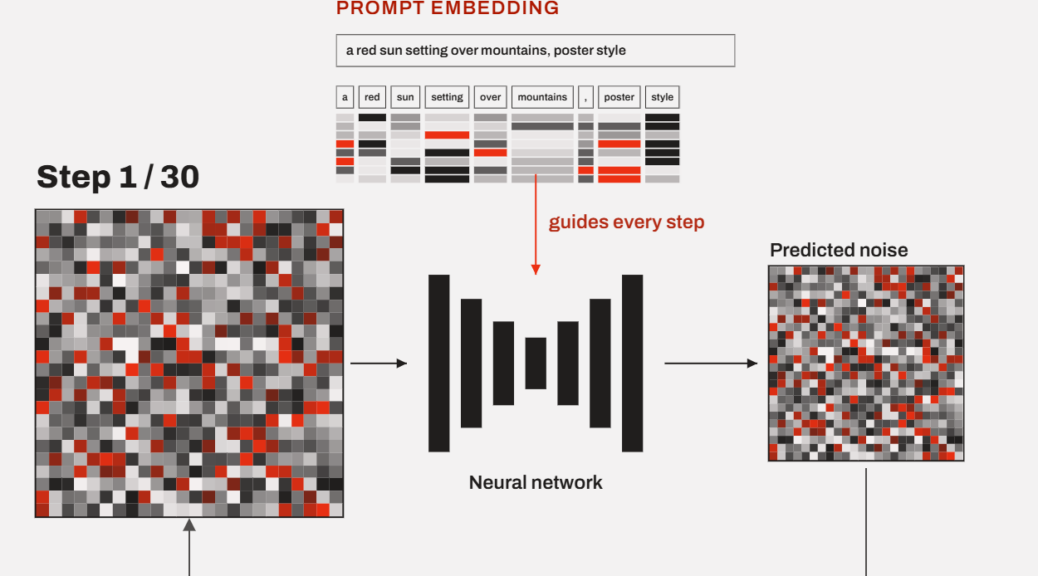
Le processus se déroule en deux étapes. Pendant l’entraînement, le modèle observe des milliards d’images accompagnées de leur légende. Il apprend ainsi le lien entre les mots et ce qu’ils représentent visuellement. Pendant la génération, il part d’une image de bruit aléatoire et la nettoie pas à pas, guidé par le texte saisi, jusqu’à obtenir une image.
Le modèle ne stocke pas les images qu’il a vues : il en retient des idées générales, comme la forme d’un soleil, d’une montagne ou un style d’affiche. Chaque image produite est donc une composition nouvelle, et non un collage d’œuvres existantes.
Prompt embedding: how a sentence steers an image model
A diffusion model can’t read words. When you type a prompt such as « Une villa de style Bauhaus au bord de mer », a tokenizer first cuts it into tokens: words or pieces of words, each with an ID. A text encoder (CLIP or T5) then turns each token into an embedding, a list of hundreds of numbers. Because tokens read each other along the way, « bord » next to « mer » comes to mean the seashore.
These embeddings sit in a meaning space where similar ideas are close together: villa near maison, Bauhaus near Gropius and toit plat. The image model never sees the words, only this geometry.
Generation starts from pure noise. At each step, a denoiser removes a little noise. Through cross-attention, every region of the image checks which tokens matter to it: « villa » shapes the building and « mer » the water. Classifier-free guidance (CFG) strengthens the prompt’s effect by comparing a prediction made with the prompt to one made without it. A negative prompt takes the empty prompt’s place, so guidance pushes the image away from what you don’t want.